Є один незручний момент, який знає кожен, хто будував продукти на базі мультимодальних моделей: GPT-4o або Claude може блискуче описати зображення, але іноді «галюцинує» деталі, яких там просто немає. Або навпаки — не помічає очевидного. Довгий час це списували на «обмеження моделі». Нове дослідження пропонує інший кут: проблема може бути не в тому, що модель знає, а в тому, куди вона дивиться.
Дослідницька група поставила просте, але важливе питання: коли VLM (Vision-Language Model) генерує текстовий опис об'єкта на зображенні, чи дійсно її механізм уваги сфокусований на відповідній ділянці? За даними arXiv, відповідь значно складніша, ніж «так» або «ні» — і саме ця складність відкриває нові можливості для тих, хто будує CV-системи.
Проблема «сліпого опису»
Уявіть класичну задачу: є фото кухні, на якій стоїть синя чашка поряд з кавомашиною. Ви питаєте модель: «Що знаходиться зліва від кавомашини?» Модель відповідає правильно. Але чи дійсно вона дивилася на цю ділянку — чи просто витягла відповідь зі статистичних патернів, вивчених під час тренування?
Це не академічне питання. Якщо модель відповідає правильно «за звичкою», а не через реальну просторову прив'язку, то у нових сценаріях — нові кути, нестандартне освітлення, незвичне розташування об'єктів — вона буде систематично помилятися. І білдери це знають на власному досвіді: продакшн завжди приносить edge cases, яких не було в датасеті.
Що відбувається всередині: механізм уваги під мікроскопом
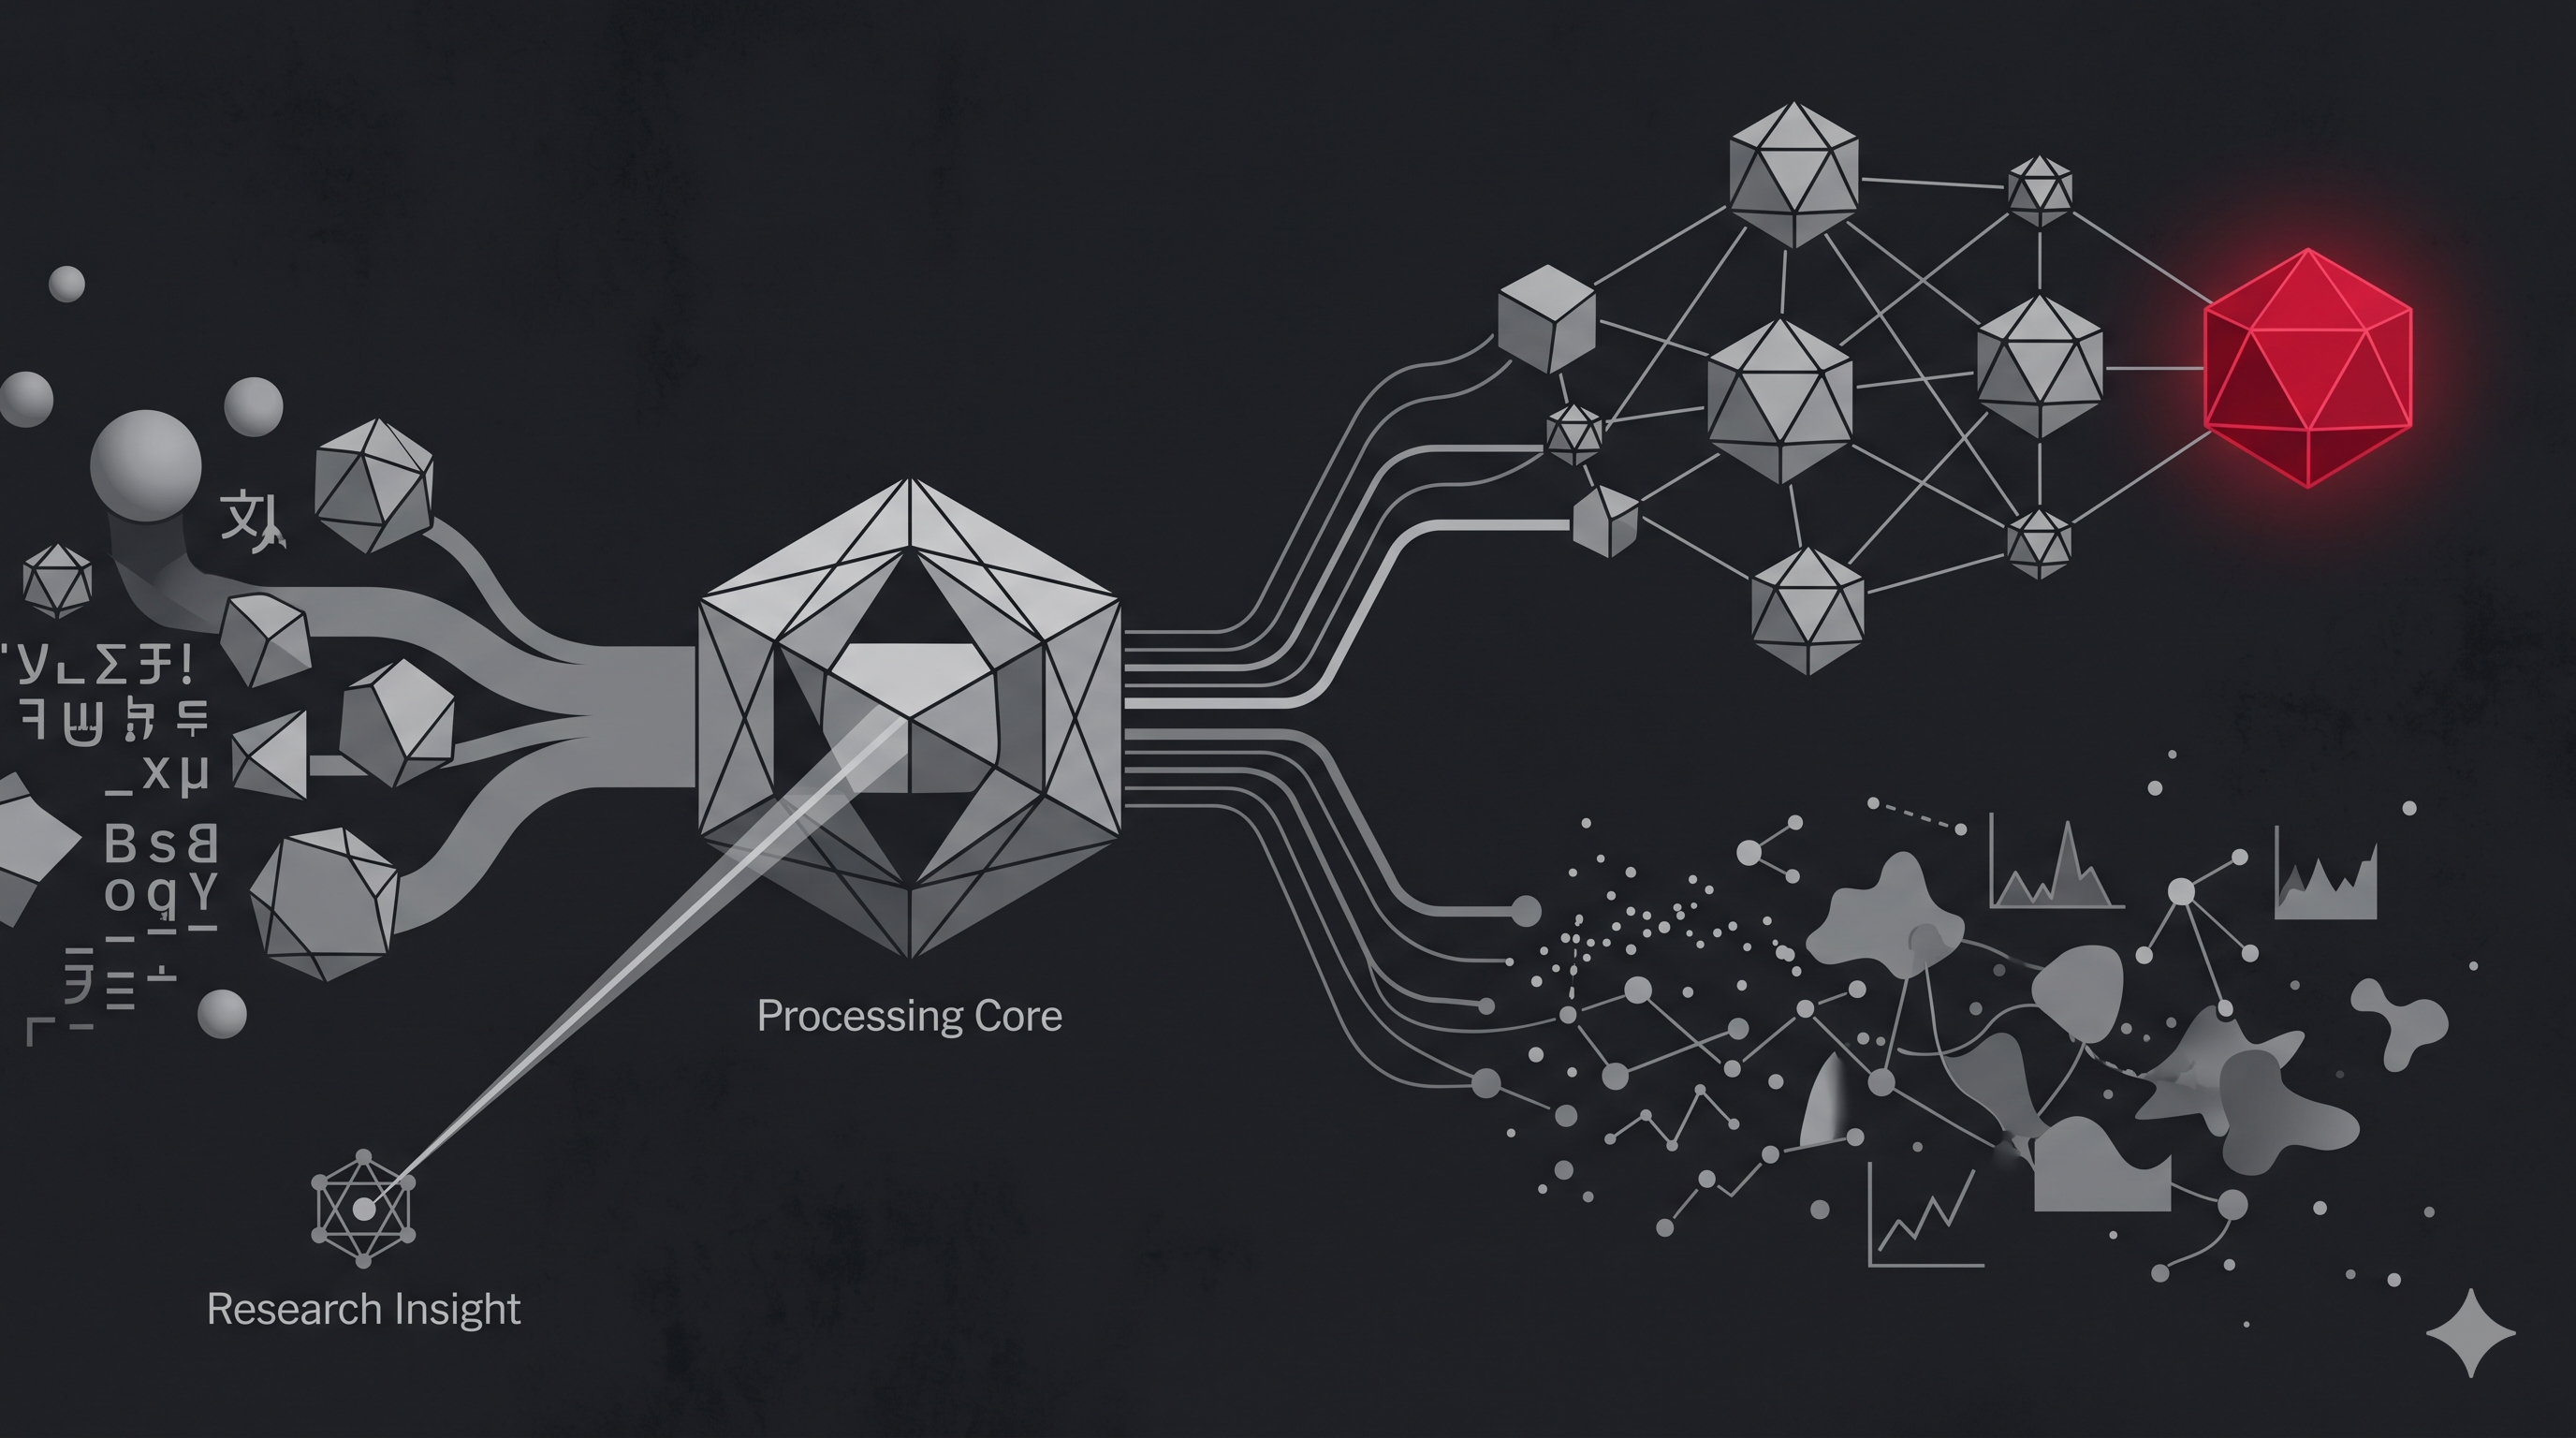
Сучасні VLM — це, по суті, зрощення двох світів: vision encoder (зазвичай ViT або подібний) і language model. Зображення розбивається на патчі, патчі перетворюються на токени, і далі мовна модель працює з ними поряд із текстовими токенами. Звучить логічно.
Але проблема в тому, що attention механізм не «знає» заздалегідь, які візуальні токени важливі для якого слова в outputs. Під час інференсу, коли модель генерує слово «чашка», вона теоретично має звертати більше уваги на токени, що відповідають ділянці з чашкою. Чи так це відбувається насправді — і є ключовим питанням дослідження.
Висновки вказують на те, що патерни уваги VLM при описі конкретних об'єктів є значно більш дифузними, ніж очікувалося. Модель «розмазує» увагу по зображенню, а не концентрується на релевантних регіонах. Це пояснює низку практичних проблем: від галюцинацій просторових відносин до труднощів з fine-grained grounding.
Порівняння з класичними підходами CV
Якщо ви починали кар'єру з класичного computer vision — YOLO, Detectron, Faster R-CNN — ви розумієте, що там архітектура змушує модель локалізувати об'єкти. Region proposal networks, anchor boxes, explicit bounding box regression — все це механізми, які буквально кажуть моделі: «ось де об'єкт, і твоя задача — точно його обмежити».
VLM будувалися за іншою філософією: let the language guide the vision. Припускалося, що мовна модель «навчиться» правильно зважувати візуальні токени через контекст. Для загальних задач це спрацювало. Але для точного grounding — прив'язки слів до конкретних пікселів — gap ще великий.
Це не означає, що VLM гірші за детектори. Вони роблять те, що детектори ніколи не могли: розуміти відкриті запити мовою. Але для задач, де потрібна точна просторова прив'язка, різниця в архітектурному підході дає про себе знати.
Що це означає для білдера
Якщо ви зараз будуєте щось на базі мультимодальних моделей, ось практичні висновки:
- Document AI та аналіз форм: якщо ваш продукт витягує дані з документів (рахунки, медичні форми, контракти), не покладайтеся виключно на VLM для просторового позиціювання. Hybrid підхід — VLM для семантики + класичний OCR з bbox для локалізації — дає значно кращі результати в production.
- Visual QA та чатботи з зображеннями: для запитань типу «що зліва від X» або «порівняй об'єкти у верхньому куті» — додавайте pre-processing: явно розмічайте регіони зображення перед подачею в модель. Prompt engineering з координатами («у регіоні [x1,y1,x2,y2] знаходиться...») суттєво підвищує точність.
- Промислова інспекція та quality control: тут висока ціна помилки. Дослідження підкреслює, що поточні VLM ненадійні для точного grounding без додаткового дообучення. Якщо будуєте CV-пайплайн для інспекції, розгляньте fine-tuning на доменних даних з явними анотаціями.
- Нові архітектурні підходи: Дослідження на arXiv відкриває конкретний напрямок для покращення моделей — explicit grounding supervision під час тренування. Якщо ви тренуєте власні мультимодальні моделі, варто включити grounding loss в training objective. Це вже роблять GLIP, Grounding DINO та подібні моделі, але для загальних VLM це все ще відкрита проблема.
Архітектурний горизонт: що зміниться
Ця робота потрапляє в контекст ширшої тенденції: індустрія починає серйозно займатися interpretability мультимодальних моделей. Поки більшість зусиль була спрямована на «що модель може зробити», питання «як саме вона це робить» отримувало менше уваги.
Але для production-систем interpretability — це не академічна цікавість. Це інструмент налагодження. Якщо ви знаєте, що модель неправильно фокусує увагу на певному типі запитів, ви можете це виправити: через prompt engineering, через додаткову обробку входу, або через дообучення на цільових прикладах.
Очікуємо, що наступне покоління VLM матиме більш явний grounding механізм — не як окрему голову, а як вбудований компонент уваги. Microsoft Research, Google DeepMind та кілька стартапів вже рухаються в цьому напрямку. Відкрита наукова робота, яка точно діагностує проблему, — це завжди крок, який прискорює рішення.
Думка редакції AiiN
Нас цікавлять не ті дослідження, які підтверджують, що AI «розумний». Нас цікавлять ті, що пояснюють, чому він іноді помиляється — і як це виправити. Робота про механізми уваги VLM при грундуванні об'єктів — саме такий випадок.
Для практиків висновок простий: не довіряйте VLM сліпо там, де важлива просторова точність. Це не критика технології — це калібрована оцінка поточного стану. Hybrid-підходи, explicit region prompting і targeted fine-tuning залишаються вашими найкращими інструментами доти, поки архітектурна проблема не вирішена на рівні базових моделей. А вона вирішиться — питання кварталів, не років.